
L'essentiel à retenir
- Google ne cherche plus l'exhaustivité absolue et filtre sévèrement l'entrée de son index pour préserver ses ressources serveur.
- Le statut « Explorée, actuellement non indexée » sanctionne un manque de qualité perçue, d'originalité ou de signaux d'expérience sur la page.
- Le statut « Détectée, actuellement non indexée » traduit généralement un domaine manquant d'autorité ou un budget de crawl dispersé sur des URL inutiles.
- Le maillage interne depuis vos pages fortes et l'obtention de liens externes restent les deux leviers prioritaires pour forcer l'exploration.
- L'assainissement technique passe par la suppression des pages zombies sans trafic et la mise en noindex des contenus sans valeur SEO.
Publier un contenu soigné sans le voir apparaître dans les résultats de recherche est devenu l’une des pannes les plus courantes en SEO. Un problème d’indexation sur Google paralyse immédiatement l’acquisition de trafic organique, réduisant à néant des semaines de travail de rédaction ou de développement.
Il y a encore quelques années, n’importe quelle page, même médiocre, s’indexait en quelques heures. Cette époque est révolue : aujourd’hui, les refus et les lenteurs d’indexation frappent tous les types de sites, des blogs personnels aux catalogues e-commerce de plusieurs dizaines de milliers d’URL.
Je n’ai pas de baguette magique pour forcer les robots du moteur, mais je constate régulièrement sur le terrain que ces blocages reposent sur des causes techniques et qualitatives très précises. Pour résoudre efficacement un blocage, il faut d’abord comprendre pourquoi les règles du jeu ont changé, puis distinguer nettement trois phases souvent confondues : le crawl (l’exploration par Googlebot), l’indexation (l’enregistrement dans la base de données) et le positionnement (le ranking sur une requête).
Comprendre les débuts de Google pour mieux cerner les problèmes actuels
La course à l’indexation
À ses débuts, Google cherchait avant tout à construire l’index le plus exhaustif possible face à ses concurrents historiques comme Yahoo ou AltaVista. La priorité du moteur consistait à aspirer chaque page disponible sur le Web afin de prouver aux internautes la supériorité de sa base documentaire. Cette logique d’accumulation systématique n’a plus lieu d’être aujourd’hui.
L’évolution du nombre de sites / pages Web
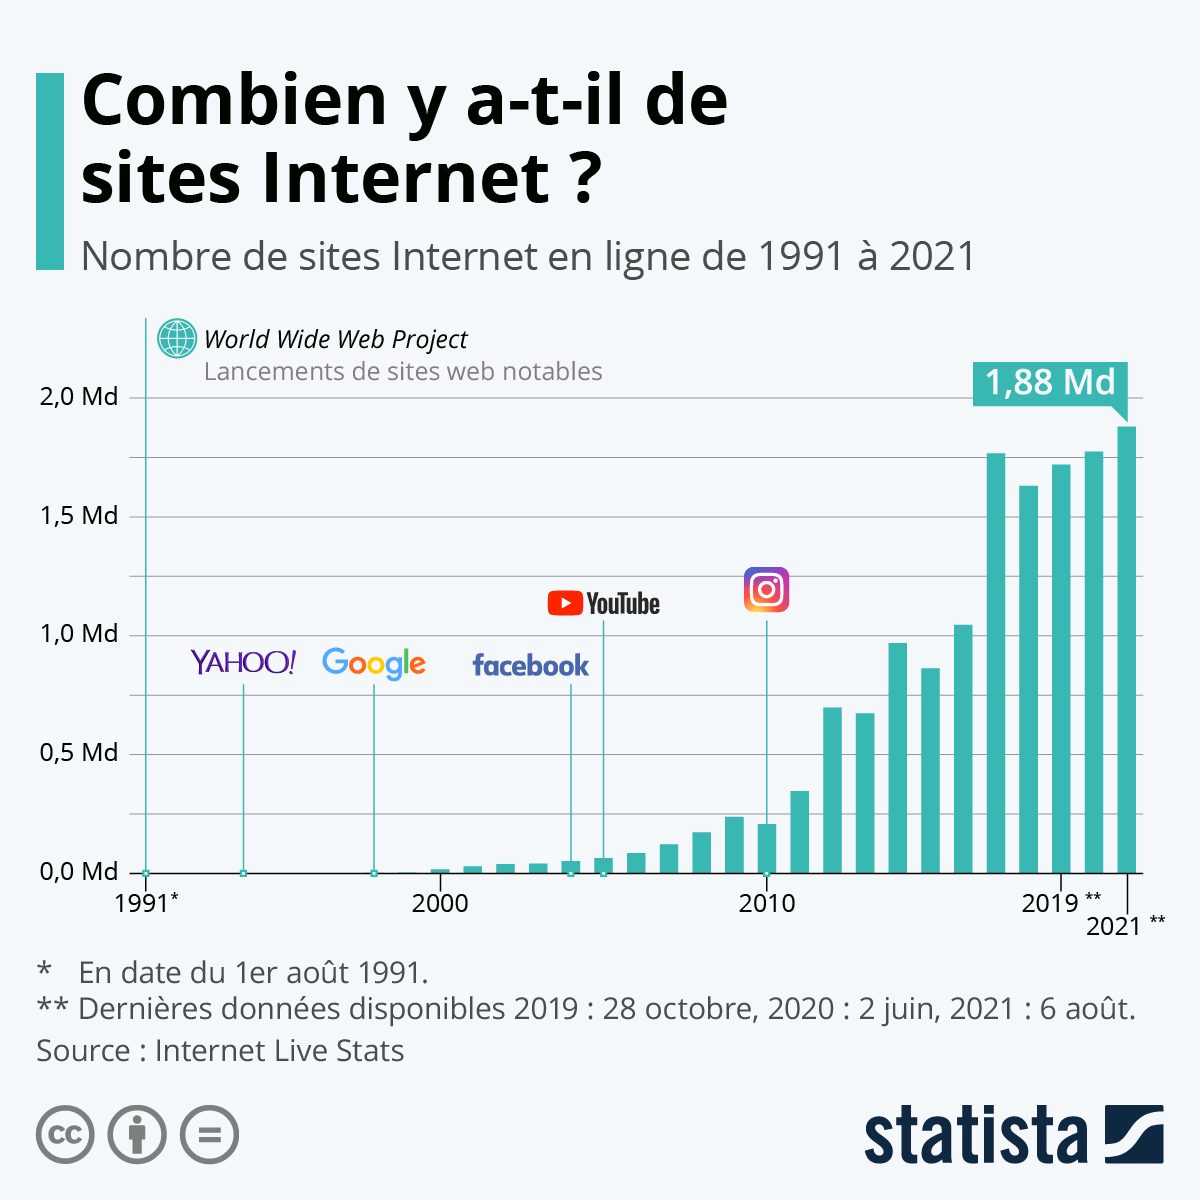
Source : Statista
À la fin des années 1990, le Web comptait moins de 3 millions de sites en ligne : l’indexation intégrale restait techniquement accessible avec les infrastructures de l’époque. Selon les relevés de Netcraft et d’Internet Live Stats, le Web totalise désormais entre 1,1 et 1,5 milliard de sites, même si environ 200 millions seulement sont réellement actifs au quotidien.
Face à ce raz-de-marée, amplifié par la création automatisée de milliards de textes générés par intelligence artificielle, stocker chaque document publié est devenu un non-sens économique et opérationnel pour le moteur.
L’allocation des ressources
Explorer, analyser le code, exécuter le JavaScript et stocker une page Web représente une dépense matérielle et énergétique colossale. Le budget de crawl alloué par Google à votre site dépend directement de son autorité perçue et de sa fraîcheur technique, et ce volume d’exploration n’est pas illimité.
Derrière la communication officielle sur la réduction de l’empreinte carbone des data centers se cache un arbitrage rationnel : Google refuse d’investir des serveurs coûteux pour indexer des pages sans valeur ajoutée, redondantes ou générées à la chaîne.
Evolution des usages, illustrations, vidéos
Les premiers sites Internet reposaient sur du texte brut très léger à analyser. Aujourd’hui, les attentes des utilisateurs ont changé : une réponse pertinente exige une mise en page soignée, des médias riches, des visuels contextuels, parfois des vidéos et une expérience mobile irréprochable.
Pour répondre précisément à l’intention de recherche d’une requête complexe, l’algorithme privilégie désormais des ressources complètes et multimédias au détriment des coquilles textuelles vides qui encombraient autrefois l’index.
Quelle conclusion tirer de tout ceci ?
L’indexation systématique et automatique de chaque nouvelle URL appartient définitivement au passé. Googlebot trie désormais les pages à la porte d’entrée de son infrastructure en séparant l’exploration du stockage effectif.
Selon la documentation officielle de Google sur la gestion du budget de crawl, le robot ne peut découvrir et explorer qu’une fraction du Web mondial, pour ensuite n’en indexer qu’un sous-ensemble trié sur le volet. Si votre page n’apporte aucun signal d’utilité immédiate, elle reste tout simplement sur le pas de la porte.
Les raisons pour lesquelles Google décide de ne pas indexer vos pages
Distinguez bien le diagnostic : une page « explorée » souffre d’un arbitrage qualitatif, alors qu’une page « détectée » signale un manque d’autorité ou un gaspillage de votre budget de crawl.
Lorsque vous analysez votre couverture dans l’outil Google Search Console sous la section Indexation, les anomalies sont regroupées sous des libellés précis. Deux statuts concentrent l’immense majorité des blocages rencontrés sur le terrain :
1 / Explorée, actuellement non indexée
Ce statut indique un constat sans ambiguïté : la mention page explorée actuellement non indexée signifie que Googlebot a téléchargé et lu le contenu, mais a décidé de ne pas le conserver dans son index. Le blocage n’est pas technique : il s’agit d’un verdict sur la valeur ou la légitimité du document.
Dans la majorité des cas observés lors de mes audits, ce statut découle des facteurs suivants :
- Une trop forte proximité textuelle avec d’autres pages internes (cannibalisation ou fiches produits quasi identiques).
- Un contenu superficiel (thin content), généré automatiquement ou sans apport d’expérience tangible (manque de signaux E-E-A-T).
- Des balises méta dupliquées ou un manque flagrant d’intérêt pour répondre à la requête ciblée.
2 / Détectée, actuellement non indexée
Le statut détectée actuellement non indexée signifie que Google connaît l’existence de votre URL (via un sitemap XML ou un lien interne), mais n’a pas encore pris la peine d’envoyer Googlebot pour la télécharger.
Ce phénomène traduit généralement un engorgement ou un manque d’intérêt manifeste pour le gabarit concerné :
- Un épuisement du budget de crawl : Googlebot se disperse sur des milliers d’URL parasites comme des facettes de tri, des paramètres d’URL infinis ou des résultats de moteurs de recherche internes.
- Un manque d’autorité global : le domaine ne dispose pas d’assez de popularité pour inciter le robot à explorer ses pages profondes.
- Des pages à très faible valeur perçue : des fiches articles en rupture de stock définitive ou des taxonomies sans aucun contenu rattaché.
Comment augmenter la probabilité que Google indexe vos pages ?
Consultez notre guide dédié pour optimiser vos catégories e-commerce sans disperser inutilement votre budget de crawl.
Découvrez notre méthode complète pour structurer des liens internes efficaces et guider Googlebot vers vos pages clés.
Avant d’ajouter de nouveaux contenus, supprimez impérativement vos pages zombies et consolidez votre maillage interne pour orienter les robots vers vos URL à forte valeur.
Pour débloquer une situation et apprendre concrètement comment indexer une page sur Google lorsqu’elle stagne, voici les leviers prioritaires à activer sur votre site.
1 / Evitez les 404
Chaque page d’erreur 404 rencontrée par un robot d’exploration représente une perte sèche de ressources serveur et de budget d’exploration. Lorsqu’un crawler fait face à des chaînes de redirections ou à des séries de liens morts, il ralentit son rythme d’exploration sur le reste de votre domaine. Corrigez ces erreurs en nettoyant régulièrement les liens internes brisés et en redirigeant proprement les anciennes URL d’autorité.
2 / Utilisez les liens internes
Le maillage interne constitue le premier signal de priorité et d’importance envoyé aux algorithmes de Google. Une page isolée ou distante de plus de trois clics depuis la page d’accueil aura les pires difficultés à être explorée, puis indexée.
- Reliez systématiquement chaque nouvel article depuis vos pages piliers les plus fortes thématiquement.
- Ne laissez aucune page orpheline hors de votre arborescence.
- Vérifiez que toutes vos pages stratégiques figurent dans un sitemap XML valide, régulièrement mis à jour et soumis dans la Search Console.
Pour approfondir la structure de vos ancres et vos silos, prenez le temps d’optimiser vos liens internes de façon contextuelle.
3 / Valorisez les contenus importants
Tous vos contenus n’ont pas vocation à encombrer les index des moteurs. Les mentions légales, les conditions générales de vente, les paniers ou les pages d’administration doivent être configurés en balise meta robots noindex pour concentrer l’effort de crawl sur les pages génératrices de business.
Sur une boutique en ligne, fermez l’accès aux filtres de navigation non stratégiques via votre fichier robots.txt pour préserver le crawl de vos pages produits et de vos catégories e-commerce.
4 / Eliminez le contenu de mauvaise qualité et le contenu dupliqué
Face au filtre de qualité de Google, traitez sans complaisance les « pages zombies » : ces publications anciennes qui ne génèrent ni visite, ni conversion, ni positionnement.
| Type de contenu problématique | Diagnostic | Action corrective recommandée |
|---|---|---|
| Pages zombies sans trafic | Zéro clic en 12 mois, sujet obsolète | Suppression (code 410) ou redirection 301 vers un sujet proche |
| Fiches produits clonées | Description fournisseur dupliquée | Réécriture avec données d’expérience, avis et tests réels |
| Sujets concurrents internes | Deux articles positionnés sur le même mot-clé | Fusion des deux URL en un seul guide complet |
Assainir l’existant rehausse immédiatement le score de qualité globale que le moteur attribue à l’ensemble de votre domaine.
5 / Poussez Google à la découverte de vos pages importantes
Pour obtenir une indexation pérenne sur un contenu concurrentiel, le maillage interne ne suffit pas toujours : les backlinks externes apportent le surcroît d’autorité indispensable. Un lien externe issu d’un site reconnu et thématiquement proche force le passage immédiat de Googlebot et confirme la pertinence de la ressource.
Complétez ce levier en utilisant l’outil d’inspection d’URL au sein de la Google Search Console pour demander manuellement une indexation ponctuelle, sans en abuser : cette requête sert de déclencheur de crawl, mais elle ne garantit jamais l’indexation si la page ne passe pas le contrôle qualité de l’algorithme.
En conclusion
Google dispose de la technologie nécessaire pour aspirer le Web, mais ses choix de stockage répondent à un impératif de rentabilité : éliminer le bruit pour ne retenir que l’information utile. Face aux milliards de pages publiées chaque jour, l’indexation est devenue un privilège algorithmique réservé aux sites propres et fiables.
Pour sécuriser la visibilité de vos contenus, concentrez vos efforts sur la structure technique de votre site, coupez les pages parasites qui gaspillent vos ressources, et apportez une réelle valeur ajoutée à chaque publication. C’est la seule méthode durable pour voir vos pages acceptées dans l’index et les y maintenir sur le long terme.
Validez vos connaissances
Pourquoi Googlebot refuse-t-il souvent d'indexer une page ayant le statut « Explorée, actuellement non indexée » ?
- Le fichier robots.txt bloque l'accès à la page
- Google a lu le contenu mais juge sa valeur ou sa pertinence insuffisante
- Le serveur a renvoyé un code d'erreur 500 lors du crawl
Afficher la réponse
Google a lu le contenu mais juge sa valeur ou sa pertinence insuffisante
Ce statut confirme que la page a été correctement téléchargée et lue, mais que le moteur a choisi de ne pas la conserver dans son index pour des raisons qualitatives.
Quel signal interne prioritaire indique à Google qu'une page est importante ?
- Le nombre de liens internes qui pointent vers elle
- La longueur brute du texte en nombre de mots
- La présence de plusieurs balises H1 sur le gabarit
Afficher la réponse
Le nombre de liens internes qui pointent vers elle
Un maillage interne solide et proche de la page d'accueil démontre directement aux moteurs la priorité éditoriale accordée à cette URL.
Que convient-il de faire avec les pages zombies qui ne génèrent aucun trafic depuis un an ?
- Les laisser intactes pour augmenter le volume total de pages indexées
- Créer des liens externes artificiels pour les ranimer
- Les supprimer, les rediriger ou les fusionner pour préserver la qualité globale du domaine
Afficher la réponse
Les supprimer, les rediriger ou les fusionner pour préserver la qualité globale du domaine
Nettoyer ou fusionner ces contenus obsolètes élève la qualité moyenne de votre site et évite de gaspiller votre budget de crawl.